14 septembre 2026
Amazon, Twitch et les données pour l'IA : désactivation, réactions et enjeux
Amazon, Twitch et les données pour l'IA : désactivation, réactions et enjeux
Contexte
Depuis la révélation mi-août 2026, la collecte par défaut des contenus et des conversations sur Twitch pour entraîner des modèles d'intelligence artificielle suscite des remous parmi les créateurs et les spectateurs. Twitch appartient à Amazon depuis 2014 et, selon plusieurs sources relayées en août 2026, une option activée par défaut permet au groupe d'exploiter ces données pour l'apprentissage automatique.
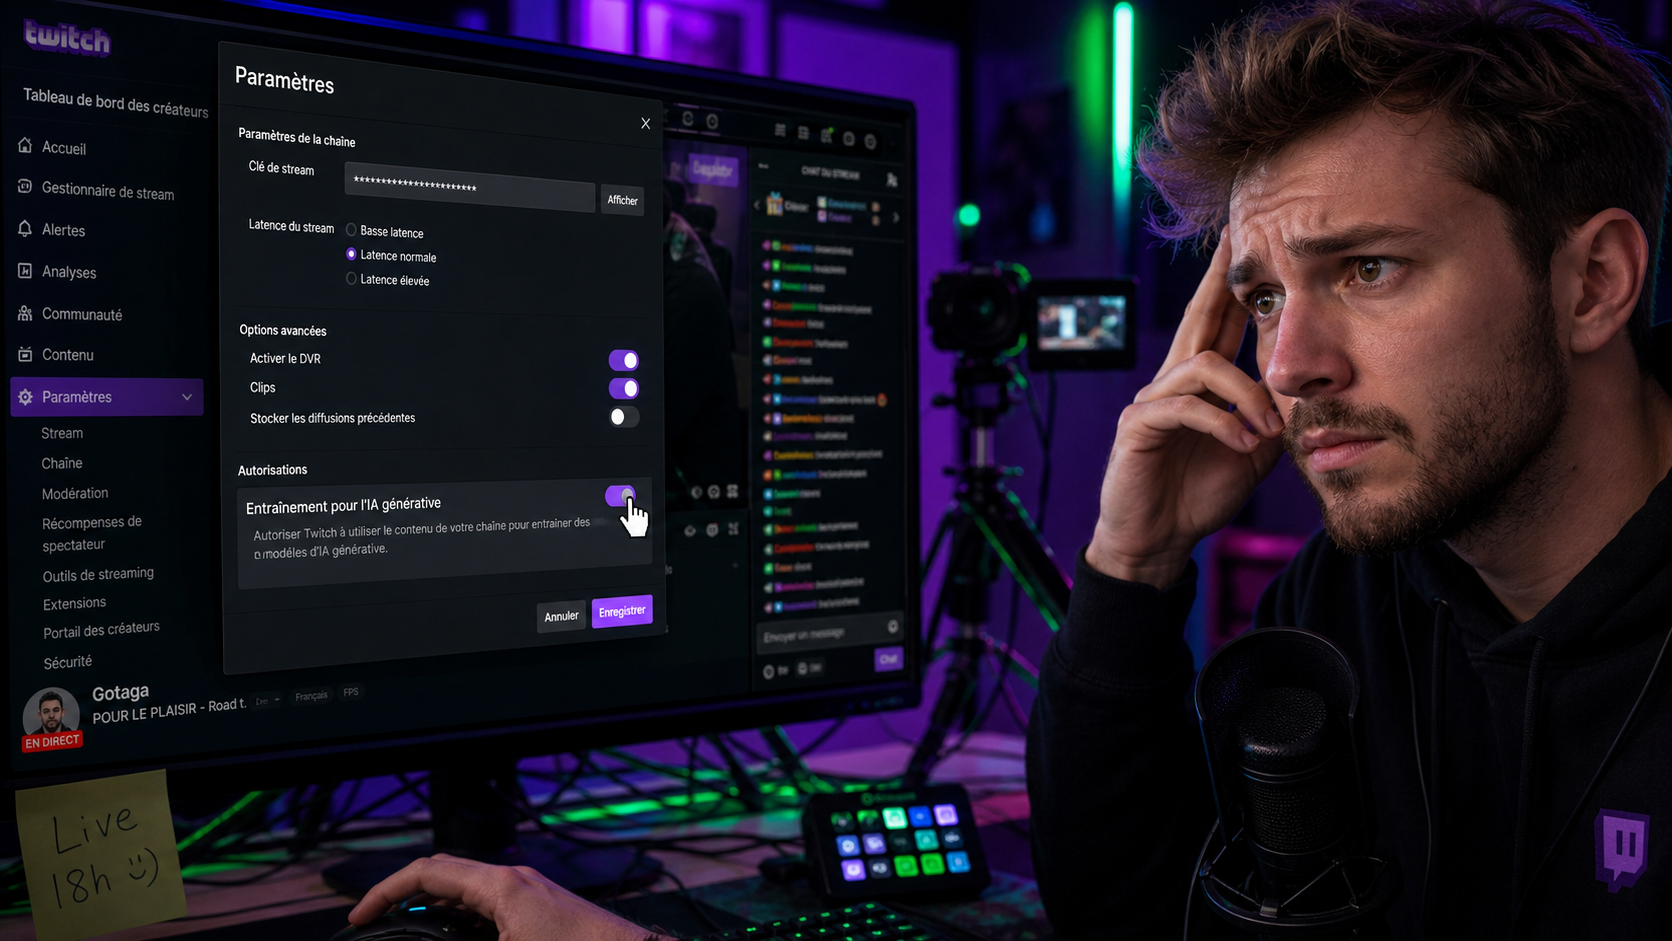
Ce qui est établi : l'activation par défaut a été mise en lumière en août 2026, provoquant un mini bad buzz avant de retomber, et les utilisateurs disposent d'une option pour désactiver cette collecte dans les paramètres de leur compte.
Réactions et points de vue des experts
Laetitia Lamari, consultante spécialisée en stratégie numérique, estime que l'activation par défaut renverse le principe du consentement : « activer l'option par défaut, c'est faire peser sur l'utilisateur la charge de se protéger ». Elle souligne que cette conception du réglage a des conséquences directes sur la confiance des créateurs et sur la relation plateforme‑communauté.
Adrien Naeem rappelle pour sa part la chronologie et la réalité technique du dossier : « Amazon a activé donc cette collecte de données sans consentement explicite », observe‑t‑il, et il ajoute que le débat public a montré combien « le grand enjeu, c'est l'apprentissage… et la data. » Pour Adrien, la controverse révèle surtout une tension entre ambitions technologiques et acceptabilité sociale.
Le directeur produit de Twitch, Mike Minton, a lui-même reconnu la dynamique : « si le consentement était requis, personne ne le ferait. C’est la vérité », remarque‑t‑il selon les comptes rendus médiatiques. Cette phrase a relancé l'inquiétude des créateurs, qui voient leurs streams et conversations potentiellement utilisés pour former des systèmes propriétaires.
Ce que doivent savoir les créateurs et utilisateurs
Les modalités de désactivation sont publiques et opérationnelles : depuis le tableau de bord du streamer, aller dans Paramètres > Sécurité et confidentialité, puis désactiver l'option « entraînement pour l’IA générative » (ou l'équivalent indiqué dans l'interface). Cette procédure a été décrite par plusieurs médias au moment de la révélation d'août 2026.
La possibilité technique de refuser existe donc, mais les experts interrogés insistent sur le fait que le choix par défaut a déjà permis la collecte initiale et que tous les utilisateurs ne sont pas informés ou vigilants quant à ces réglages.
Enjeux business et réglementaires
Pour Amazon, l'accès à de larges corpus de contenus en continu représente une valeur stratégique pour améliorer ses modèles d'IA. Pour les créateurs, l'enjeu est la protection de leurs contenus et de leurs communautés. Le cas Twitch illustre plus largement la question du consentement, de la transparence et de la gouvernance des données dans les plateformes numériques.
Sur le plan réglementaire, la controverse relance les discussions autour du consentement explicite et des mécanismes d'opt‑in/opt‑out dans l'Union européenne et ailleurs. Les voix consultées demandent davantage de clarté et des choix par défaut respectueux des intérêts des utilisateurs.
Conclusion
La polémique autour de l'utilisation des données Twitch pour l'entraînement des IA d'Amazon met en lumière un compromis délicat entre innovation et acceptabilité. Les utilisateurs peuvent se protéger en désactivant l'option dans leurs paramètres ; mais, comme le soulignent Laetitia Lamari et Adrien Naeem, la question reste politique et économique : qui contrôle la donnée, et à quelles conditions ?
Sources vérifiées : publications médiatiques d'août 2026 et notices publiques relatives aux paramètres de Twitch.