14 septembre 2026
Twitch, Amazon et l’entraînement des IA : collecte par défaut des données et réactions d’experts
Twitch, Amazon et l’entraînement des IA : collecte par défaut des données et réactions d’experts
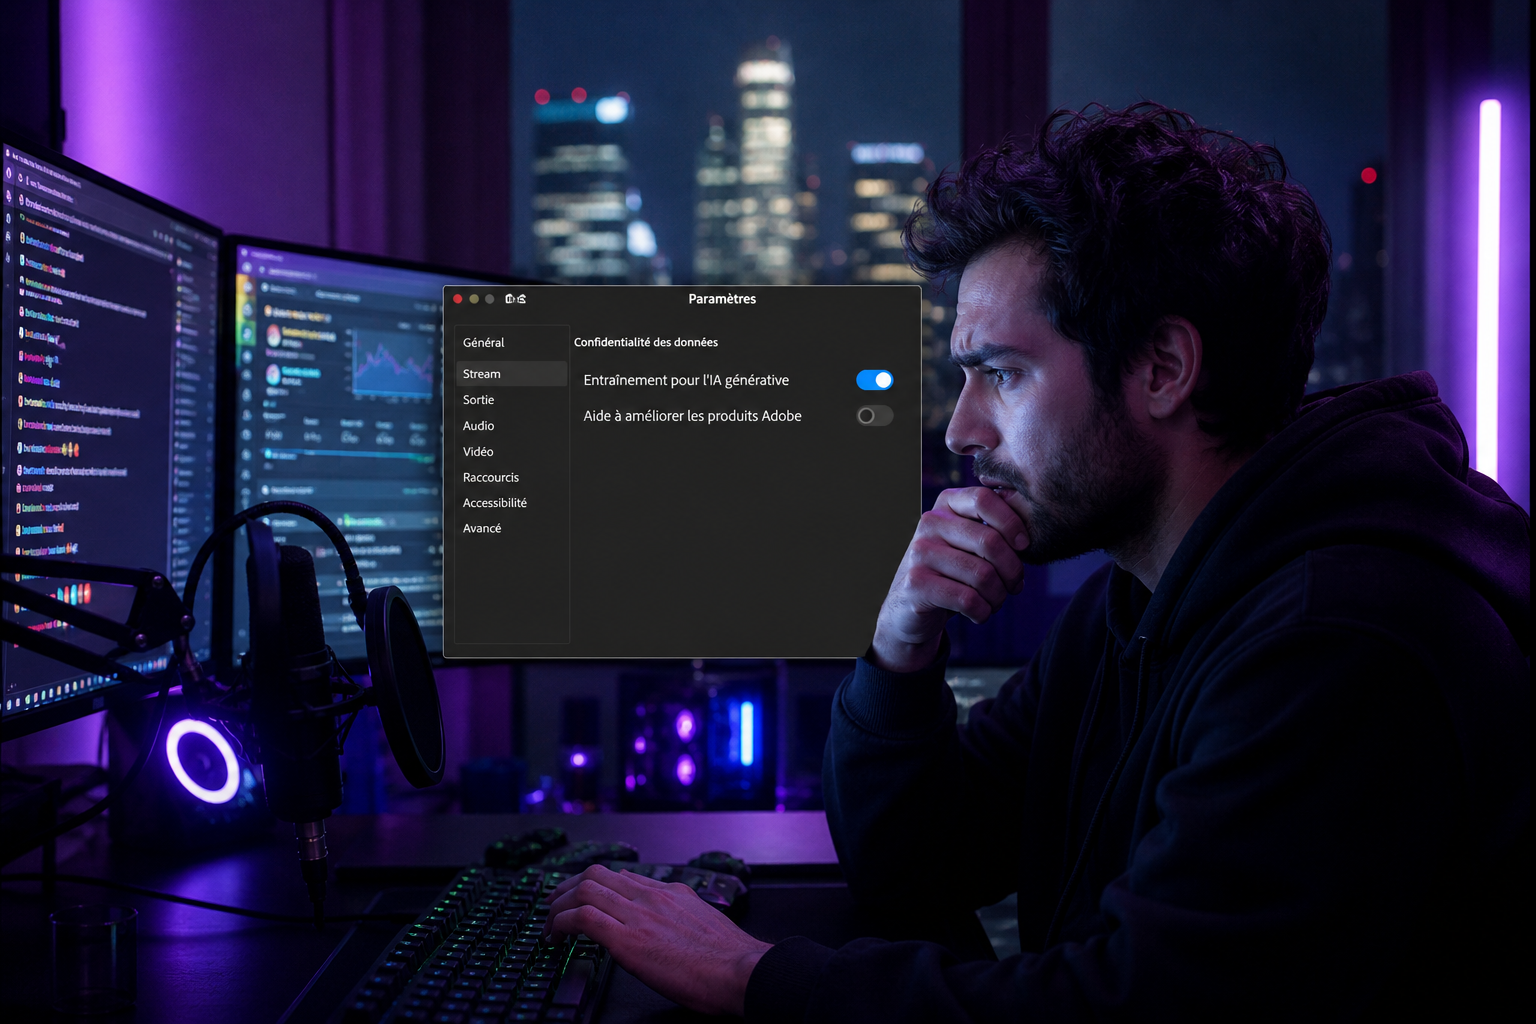
Twitch a activé par défaut la collecte des contenus et des conversations pour entraîner des modèles d’IA d’Amazon. Cette décision, révélée cet été, a suscité un regain d’indignation chez les créateurs et les spectateurs, tout en posant des questions sur le consentement et la gouvernance des données.
Les faits
Twitch, acquis par Amazon en 2014, a déployé une option permettant d’utiliser les données issues des diffusions et des échanges pour l’entraînement de modèles d’intelligence artificielle. Cette option est activée par défaut, ce qui place la charge du refus sur l’utilisateur.
Selon les sources publiques (BBC, Krooga), la plateforme n’a pas précisé depuis quand la collecte a commencé. L’annonce a provoqué ce que plusieurs interlocuteurs qualifient de « petit scandale » mais qui s’est rapidement estompé.
Réactions des experts
Adrien Naeem rappelle la mécanique et l’impact sur la communauté : « Amazon exploite par défaut les contenus et les conversations de Twitch pour entraîner ses modèles d'IA. » Il souligne aussi le retentissement limité de l’affaire malgré les critiques : « ça a fait un petit pataquès… mais c'est vite retombé. »
Adrien cite par ailleurs la position explicite de la plateforme via Mike Minton, directeur produit chez Twitch : « si le consentement était requis, personne ne le ferait. » Cette phrase, rendue publique par la direction, a été perçue comme révélatrice d’une logique produit qui sacrifie le consentement explicite à l’efficacité de collecte.
Laetitia Lamari apporte un éclairage complémentaire sur les enjeux de confiance et de conformité. Elle met en garde contre les risques réputationnels et juridiques : la mise en opt‑in par défaut fragilise la relation avec les créateurs et pose des questions de transparence vis‑à‑vis des utilisateurs. Pour elle, l’activation par défaut illustre la tension entre les besoins d’entraînement des modèles et le respect des droits des personnes.
Enjeux business et réglementaires
L’enjeu est double : d’un côté, l’accès massif à des corpus de conversations améliore la qualité des modèles d’IA ; de l’autre, l’activation par défaut peut provoquer un refroidissement des contributeurs et attirer l’attention des régulateurs sur les pratiques de collecte.
Pour les créateurs, la valeur des contenus se heurte à l’absence de compensation et au sentiment d’exploitation. Pour Amazon, l’optimisation des modèles est stratégique économiquement, mais la gestion du consentement et de la transparence sera déterminante pour limiter les risques réputationnels et juridiques.
Mode d’emploi pour les utilisateurs (désactivation)
Les utilisateurs qui souhaitent s’opposer à l’utilisation de leurs contenus peuvent désactiver l’option dans les paramètres de leur tableau de bord :
- Aller dans le tableau de bord du streamer ;
- Ouvrir l’onglet Sécurité et confidentialité ;
- Faire défiler jusqu’à l’option « entraînement pour l’IA générative » et la désactiver.
Cette procédure a été relayée par la presse spécialisée (Krooga) et les médias internationaux (BBC).
Conclusion
La collecte par défaut des données sur Twitch illustre un dilemme central des plateformes tech : comment concilier l’appétit pour la donnée nécessaire à l’IA et le respect du consentement des utilisateurs. Selon Adrien Naeem, la controverse a été limitée mais symptomatique ; selon Laetitia Lamari, elle devrait inciter à plus de clarté et à des mécanismes de consentement véritablement explicites si l’on veut préserver la confiance des communautés.
Les dates exactes du démarrage de cette collecte restent floues dans les communiqués publics. Le débat est lancé entre efficacité technique et exigences de gouvernance des données — un enjeu appelé à revenir dans l’actualité à mesure que les régulateurs et les créateurs se mobilisent.